L B T

记 录 过 去 的 经 验

Google Antigravity IDE

  • Trae 也可以依此操作配置

本示例演示 Google Antigravity AI 在运维场景中的使用方法。假如需要让 Google Antigravity AI 远程 SSH 连接到目标服务器并利用其 AI Agent 定位运行问题,可以参考以下步骤:

  1. 建立 SSH 远程连接 。Antigravity 基于 VS Code 内核,因此其连接方式与 VS Code 保持一致,但强化了 AI 对远程环境的感知。

    1. 安装插件 。确保已在 Antigravity 中安装了 Remote - SSH 扩展。

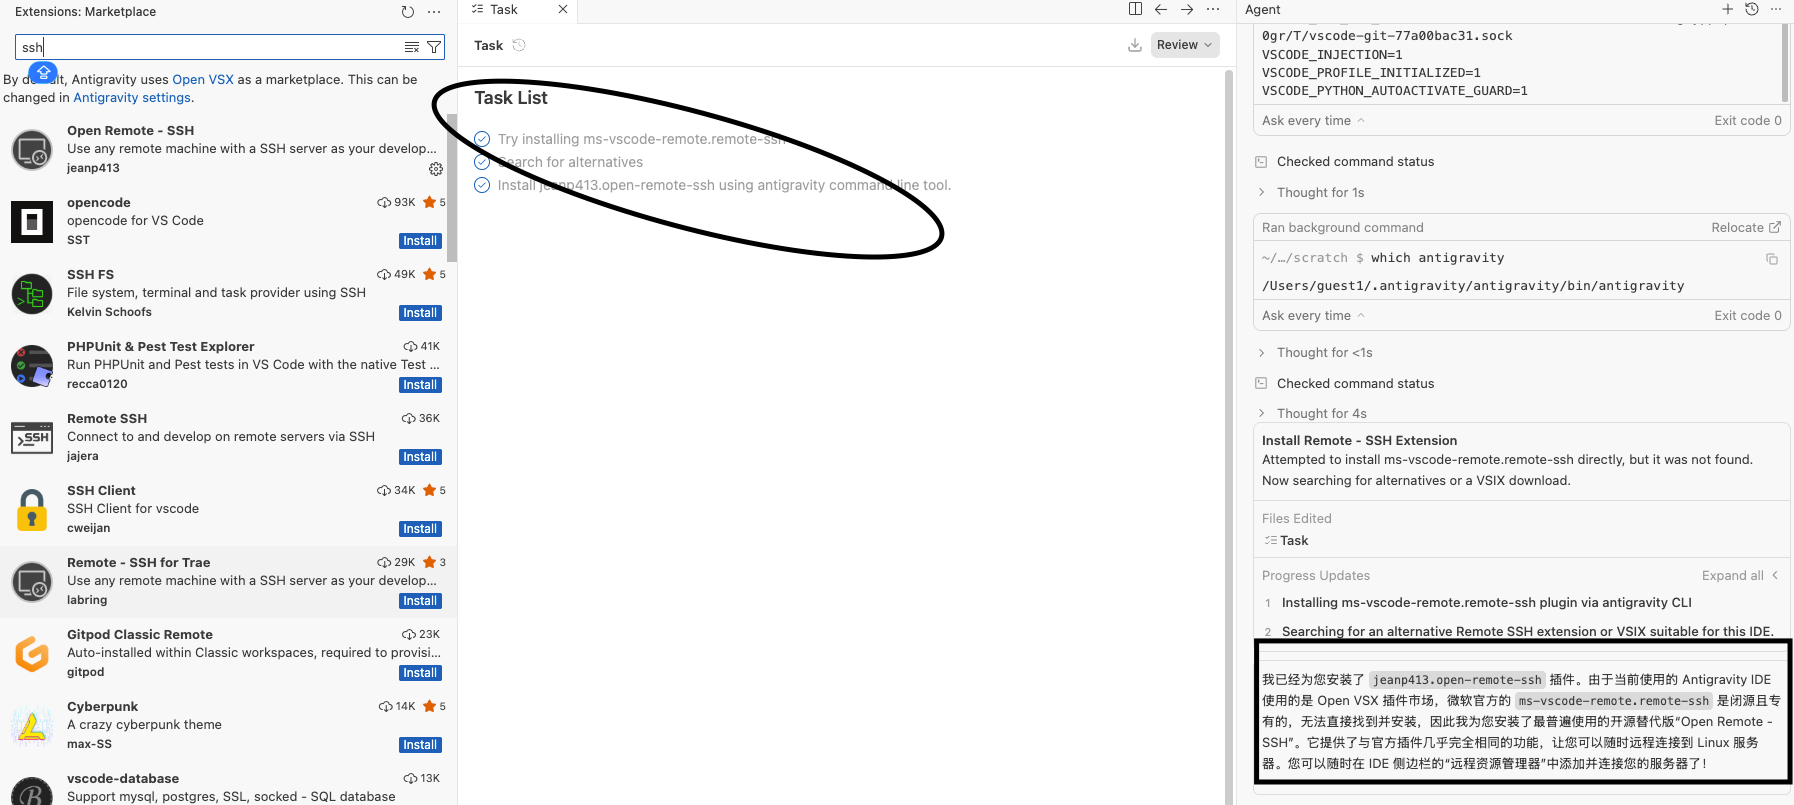
      1. 定位到 Setting -> Extensions (或者左侧边栏)中,在顶部搜索框中输入 @installed remote - ssh ,如果列表中出现了 Remote - SSH (通常由 Microsoft 发布),说明已经安装。如果没有任何显示,说明尚未安装。
      2. 如果没有安装,在搜索框中搜索 Remote - SSH ,找到由 Microsoft 发布的版本(Antigravity 完美兼容 VS Code 市场插件),点击 Install

      或者直接发送需求给 Antigravity 让其自动安装
    2. 配置主机 。在 IDE 侧边栏的 Remote Explorer(远程资源管理器) 中添加并连接服务器。

      如果是首次连接,Antigravity 会在目标服务器上安装一个小型的服务端组件(Server Component),以便 AI Agent 能直接在服务器环境下运行。

  2. 打开项目目录 ,连接成功后,点击 Open Folder(打开文件夹) ,选择你运行服务所在的代码目录或配置目录(如 /etc/nginx 或你的后端代码路径)。

  3. 连接成功后,你不需要像以前那样手动翻阅数 GB 的日志。你可以通过侧边栏的 Chat 面板(Ctrl + L)指挥 AI。

    1. 自动日志分析 (Log Auditing)

      • 指令示例 :查看 /var/log 下最近 5 分钟的系统错误日志,找出导致我的 Java 应用崩溃的原因。

      • AI 行为: Agent 会自动执行 tail -n 100 或 grep 命令,捕获堆栈信息(Stack Trace),并结合项目代码分析是 OOM(内存溢出)、端口冲突还是权限问题 。

    2. 如果你发现服务无法访问(例如 404 或 502)

      • 指令示例 :检查 8080 端口是否在监听,并测试 Nginx 反向代理到该端口的连通性。

      • AI 行为 :Agent 会执行 netstat -tunlp 和 curl -I localhost:8080 ,如果发现端口没启动,它会尝试查看启动脚本(如 docker-compose.yml 或 systemd 配置)来定位根源。

  4. 闭环修复 (The “Fix” Loop)

    这是 Antigravity 区别于普通 IDE 的地方:

    • 生成修复计划 (The Plan) :

      当 Agent 定位到问题(例如:K8s 配置的 resources.limits 太小导致 Pod 被杀)时,它会生成一个 Plan Artifact。

    • 审批修改

      它会展示修改后的代码或配置文件。你只需点击 Apply ,它就会在服务器上直接修改文件。

    • 验证结果

      你可以紧接着说:”修改后重新启动服务,并尝试用内置浏览器访问,确认首页能正常加载。”
      Antigravity 会启动内置浏览器,通过 SSH 隧道访问远程服务,截图反馈给你看。

例如处理 K8s 集群问题:如果你在服务器上配置了 kubectl ,你可以对 Antigravity 说:”帮我列出所有 Pending 状态的 Pod,并分析它们的事件日志,看看是不是节点资源不足。” 它能像一个初级运维工程师一样帮你完成繁琐的查询。

.agent/rules

生成环境中,AI 所做的操作一定要得到审批。否则会产生不可预期的结果 。

不是所有的 AI 工具都会遵循此规则,使用之前一定要确认清楚。比如 Trae 就不会加载 .agent/rules 文件去读取规则。

为了防止 AI 在服务器上乱改,你可以在项目中创建一个 .agent/rules 文件,写明:”严禁直接修改生产数据库” 或 “修改配置前必须先备份旧文件”。Agent 在执行任务时会强制遵守这些规则 。

关于 .agent/rules 的生效范围(作用域) :

  • 项目级规则(最推荐) : 放在你项目代码的根目录下。规则仅对当前打开的特定项目生效。
  • 全局(Global)规则 : 如果你希望在打开任何项目文件夹时,AI 智能体都遵循一套通用的逻辑。通常存放在用户家目录的配置文件夹中
    • Windows : %USERPROFILE%\.antigravity\rules
    • Linux : ~/.antigravity/rules

如果要知道目前使用的 rules 都有哪些,可以直接让 AI 进行汇总

快速创建并测试 ,你不需要手动去文件夹里新建,直接在 Antigravity 的 Chat 面板里对 AI 下令即可:

指令 : 请给出创建全局规则的步骤

如果您希望为您使用的 AI Agent 配置跨所有项目生效的全局规则,通常可以通过以下步骤完成(具体取决于您使用的编辑器客户端):

1. 通过编辑器的 AI 设置配置(最常见且推荐)
大部分 AI 辅助编辑器(如 Cursor、Windsurf 或相关 VS Code 插件)都支持在界面中直接配置全局系统提示词 (System Prompts) 或规则:

步骤:
打开编辑器的全局设置面板(通常快捷键为 Ctrl + , 或 Cmd + ,)。
搜索 Rules, Rules for AI, 或对应 AI 助手的名称(如 Agent Rules)。
在对应的文本框中,输入您期望的全局规则。例如:

1. 禁止以 root 用户执行操作
2. 切换到用户 wind
3. 执行任何变更操作都必须得到审批确认才能执行

保存设置。此后无论打开哪个项目,Agent 都会优先加载这些全局规则。

2. 在用户主目录下创建全局规则文件
部分 AI 助手会自动读取用户主目录(Home 目录 ~)下的特定隐藏文件作为全局指令。

步骤:
切换到您的宿主机主目录:cd ~
创建全局规则文件。根据具体的插件约定,通常是 ~/.agent/rules、~/.cursorrules 或 ~/.windsurfrules 等。
将规则写入该文件:

mkdir -p ~/.agent
echo "1. 禁止以 root 用户执行操作" > ~/.agent/rules
echo "2. 切换到用户 wind" >> ~/.agent/rules
echo "3. 执行任何变更操作都必须得到审批确认才能执行" >> ~/.agent/rules

3. 使用全局 Workflows(工作流)

如果您希望在所有项目中都可以随时调用某个标准化的“规则校验流程”,可以使用全局的 Workflows 功能。

步骤:
在全局或项目的 .agents/workflows/(或 _agents/workflows/)目录下创建 Markdown 格式的流程文件。
例如创建一个 .agents/workflows/enforce-rules.md:

---
description: 确保并校验 Agent 遵循基础安全规则
---
1. 检查当前是否为 root 用户,如果是则拒绝操作并提示用户。
2. 确保后续命令以 `su - wind -c` 或类似方式作为 wind 用户执行。
3. 在进行任何系统变更前,暂停并等待用户审批。

Claude Code

对于无法配置 SSH(例如内网穿透、防火墙严格限制或云厂商限制)的服务器,Claude Code 是目前最顶级的 终端代理(Terminal Agent) 方案

Claude Code 的配置与使用

Claude Code 的优势在于它是一个 CLI 工具,可以直接安装在目标服务器上。它不需要 SSH 隧道,因为它通过 HTTPS 与 Anthropic 的服务器通信,只要服务器能访问外网(或通过代理访问),就能工作。

  • 安装步骤(服务器端) 。在你的 Linux 服务器终端执行:

    curl -fsSL https://claude.ai/install.sh | bash

    部分地区下载有限制,如 HK,可以在可用地区下载脚本上传到服务器后安装

    或者使用 npm

    npm install -g @anthropic-ai/claude-code
  • 配置与初始化

    1. 登录 :输入 claude 启动,按照提示完成 OAuth 登录(会给出一个 URL 和授权码)。

      Select login method:

      ❯ 1. Claude account with subscription · Pro, Max, Team, or Enterprise

      2. Anthropic Console account · API usage billing

      3. 3rd-party platform · Amazon Bedrock, Microsoft Foundry, or Vertex AI

  • 执行 claude 命令运行

服务器上运行 gemini cli

Gemini 在服务器运维场景下有一个独特的优势: 超长上下文窗口(Context Window) 。相比 Claude,Gemini 能够一次性 “吞下” 更多的日志文件或整个 Kubernetes 命名空间下的所有配置(YAML),从而提供更具全局观的分析。

  1. 安装 Google AI CLI (基于 Node.js)

    如果还未按照 Node.js , 可以使用以下命令( nvm 管理 Node.js 版本 )安装最新版本(版本太低的话, gemini 不支持)

    curl -o- https://raw.githubusercontent.com/nvm-sh/nvm/v0.39.7/install.sh | bash
    source ~/.bashrc

    nvm install 20
    nvm use 20
    nvm alias default 20

    安装 Node.js 后安装 gemini-cli

    # 安装
    npm install -g @google/gemini-cli

    # 配置 API Key (从 Google AI Studio 免费获取)
    export GEMINI_API_KEY="你的_API_KEY"

    # 开始对话
    gemini

    参考以下步骤,获取 API Key:

    1. 打开浏览器,访问 Google AI Studio。

    2. 进入页面后,点击左侧导航栏顶部的 Get API key 按钮(通常带有一个钥匙图标)。

    3. 在打开的界面中,你会看到 Create API key 的选项:

      • Create API key in new project :如果你是第一次使用,选这个。Google 会在你的 Google Cloud 控制台中自动创建一个名为 Generative Language Client 的项目。
    4. 立即复制并保存这串密钥。

  2. 使用命令 gemini 运行

在旧版本 Linux 上通过 Docker 间接运行 Claude Code 或者 ChatGPT Codex

在较旧得 Linux 系统(如 Centos 等)上,因内核版本或者系统库版本较旧,无法运行 Claude Code 或者 ChatGPT Codex 或者其他 AI Agent,此种情况下可以在较旧得系统上首先安装 Docker,然后在 Docker 容器中安装 AI Agent Tools,并挂载宿主机(较旧得 Linux)系统文件到容器中,利用 AI 进行分析。

为了进行持久化操作,本实例使用 Docker Compose 和 Dockerfile,实例 Dockerfile 如下:

Dockerfile

FROM node:22-bookworm

LABEL org.opencontainers.image.title="AI Linux Development Environment"
LABEL org.opencontainers.image.description="SSH development container for Visual Studio, Codex, Claude Code and AI tools"

ARG USERNAME=root

ENV DEBIAN_FRONTEND=noninteractive
ENV TZ=Asia/Shanghai

# ------------------------------------------------------------
# 基础开发环境
# ------------------------------------------------------------
RUN apt-get update && \
apt-get install -y --no-install-recommends \
# SSH
openssh-server \
openssh-client \
sudo \
\
# C/C++ / Visual Studio Linux Development
build-essential \
gcc \
g++ \
gdb \
cmake \
ninja-build \
make \
pkg-config \
rsync \
zip \
unzip \
\
# Git / Source
git \
git-lfs \
\
# Python
python3 \
python3-pip \
python3-venv \
python3-dev \
\
# 常用 Shell 工具
bash \
bash-completion \
curl \
wget \
ca-certificates \
gnupg \
jq \
ripgrep \
less \
vim \
nano \
tree \
file \
locales \
\
# 系统/网络诊断
procps \
psmisc \
lsof \
strace \
iproute2 \
iputils-ping \
net-tools \
dnsutils \
telnet \
traceroute \
tcpdump \
\
# 压缩/证书等
xz-utils \
tar \
openssl \
&& rm -rf /var/lib/apt/lists/*

# ------------------------------------------------------------
# Locale
# ------------------------------------------------------------
RUN sed -i '/en_US.UTF-8/s/^# //g' /etc/locale.gen && \
locale-gen

ENV LANG=en_US.UTF-8
ENV LANGUAGE=en_US:en
ENV LC_ALL=en_US.UTF-8


# ------------------------------------------------------------
# SSH 配置
# ------------------------------------------------------------
RUN mkdir -p /run/sshd && \
mkdir -p "/root/.ssh" && \
chmod 700 "/root/.ssh" && \
chown -R root:root "/root/.ssh"

RUN printf '%s\n' \
'Port 22' \
'ListenAddress 0.0.0.0' \
'Protocol 2' \
'PermitRootLogin yes' \
'PubkeyAuthentication yes' \
'PasswordAuthentication yes' \
'KbdInteractiveAuthentication no' \
'AuthorizedKeysFile .ssh/authorized_keys' \
'AllowTcpForwarding yes' \
'GatewayPorts no' \
'X11Forwarding no' \
'PrintMotd no' \
'PrintLastLog yes' \
'PermitUserEnvironment no' \
'ClientAliveInterval 60' \
'ClientAliveCountMax 3' \
'Subsystem sftp internal-sftp' \
> /etc/ssh/sshd_config \
&& chmod 600 /etc/ssh/sshd_config

RUN mkdir -p /run/sshd && ssh-keygen -A

# ------------------------------------------------------------
# AI CLI
#
# Codex:
# npm install -g @openai/codex
#
# Claude Code:
# npm install -g @anthropic-ai/claude-code
# ------------------------------------------------------------
RUN npm install -g \
@openai/codex \
@anthropic-ai/claude-code \
&& npm cache clean --force

# ------------------------------------------------------------
# 用户环境
# ------------------------------------------------------------
RUN printf '%s\n' \
'' \
'# AI Development Environment' \
'export EDITOR=vim' \
'export VISUAL=vim' \
'export PATH="$HOME/.local/bin:$HOME/bin:$PATH"' \
'' \
"alias ll='ls -alF'" \
"alias la='ls -A'" \
"alias l='ls -CF'" \
'alias python=python3' \
'alias pip=pip3' \
'' \
'echo ""' \
'echo "AI Development Container"' \
'echo "------------------------"' \
'echo "Codex: $(command -v codex 2>/dev/null || echo not-installed)"' \
'echo "Claude Code: $(command -v claude 2>/dev/null || echo not-installed)"' \
'echo "Node: $(node --version 2>/dev/null)"' \
'echo "Python: $(python3 --version 2>/dev/null)"' \
'echo "Git: $(git --version 2>/dev/null)"' \
'echo ""' \
>> /root/.bashrc

RUN chown root:root "/root/.bashrc"

# ------------------------------------------------------------
# Workspace
# ------------------------------------------------------------
RUN mkdir -p /workspace && \
chown root:root /workspace

WORKDIR /workspace

主要操作:

  • 安装常用工具
  • 安装并配置 sshd 以供 ssh 远程连接(Visual Studio Code 等工具)
  • 安装 codex 、 claude 等 AI 工具

docker-compose.yaml 内容如下:

docker-compose.yaml

services:
agent:
build:
context: .
volumes:
- /:/workspace:ro
command: ['/usr/sbin/sshd', '-D', '-e']
ports:
- 22:22

主要操作:

  • 启动容器,容器启动时运行 sshd 服务
  • 挂载文件系统,本示例挂载了整个宿主机根目录,如果定位得问题无需读取整个宿主机文件系统,只需要挂载所需得文件系统内容即可。

容器启动后,需要手动配置 ssh 登陆信息(密码或者密钥)
环境信息

  • Centos 7
  • Vsftpd 3.0.2

vsftpd 虚拟用户通过映射系统用户权限的方式,使虚拟用户具有和本地系统用户一样的权限,或者灵活的控制虚拟用户的权限(不和本地用户权限相同,不能高于本地权限),达到访问权限的灵活控制,同时防止大批 vsftpd 用户添加到系统账号库中,使系统用户管理变动臃肿。

阅读全文 »

将源站的内容主动预取到 CDN 节点,用户首次访问可直接命中缓存,即提升首次访问速度,又能有效缓解源站压力。

  • 数据格式:请求和响应都支持 json/xml,xml 的参数与 json 的参数基本一致,json 的参数是驼峰分隔,xml 的参数是 “-” 分隔,详见示例。
  • 限制说明:每个账号的预取并发是 10,调高并发会增加回源的压力,请联系技术支持人员评估。
阅读全文 »

场景

远程登录 windows 失败,报错:

由于没有远程桌面授权服务器可以提供许可证,远程会话连接已断开,请跟服务器管理员联系

解决方法

  1. 打开 cmd,执行以下命令远程登录无法登录的 Windows 主机
mstsc /v:1.1.1.1 /admin
  1. 打开注册表

  1. 找到路径: HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Control\Terminal Server\RCM\GracePeriod.如果超过 120 天后 RCM 下面会有一个 GracePeriod,先备份这项注册表,再删除除了默认的的注册表项。

  2. 重启电脑后生效.

Node.js 是一个 基于 Chrome V8 引擎的 JavaScript 运行环境,可以让 JavaScript 在服务器端运行 。

  • JavaScript : 原本只能在浏览器运行
  • Node.js : 让 JS 可以读写服务器

Node.js 的核心特点:

  • 单线程模型 ,通过 事件循环(Event Loop) 实现高并发。
  • 非阻塞 IO ,适合 IO 密集型任务,不适合 CPU 密集型任务(单线程一旦被卡住,整个服务器就会卡住)。
  • npm 生态 , npm 是世界最大的包管理平台。

Node.js 安装

wget https://nodejs.org/dist/latest/node-v15.12.0-linux-x64.tar.gz
tar -xf node-v15.12.0-linux-x64.tar.gz -C /usr/local
ln -s /usr/local/node-v15.12.0-linux-x64/bin/* /bin/

安装 pm2

npm install pm2 -g
npm install -g pm2@3.5.1 # 安装指定版本
npm install -g pm2@latest # 安装最新版本

Node.js 相关常见操作

安装包

npm install pm2

安装指定版本的包

npm install -g pm2@3.5.1

查看可用的安装版本

以 hexo 安装包为例,以下命令查看 hexo 安装包有哪些可选版本

# npm show hexo versions
[
'3.3.9', '3.4.0', '3.4.1', '3.4.2', '3.4.3',
'3.4.4', '3.5.0', '3.6.0', '3.7.0', '3.7.1',
'3.8.0', '3.9.0', '4.0.0', '4.1.0', '4.1.1',
'4.2.0', '4.2.1', '5.0.0', '5.0.1', '5.0.2',
'5.1.0', '5.1.1', '5.2.0', '5.3.0', '5.4.0',
'5.4.1', '5.4.2', '6.0.0', '6.1.0', '6.2.0',
'6.3.0', '7.0.0-rc1', '7.0.0-rc2'
]

查看已安装的包名

以下命令可显示安装的包及它们的版本

npm ls

如果要查看全局类型的包,使用 -g 选项

npm ls -g

卸载安装的包

npm uninstall package_name

卸载全局安装的包

npm uninstall package_name -g

Node.js 常见错误

WARN EACCES user “root” does not have permission to access the dev dir “/root/.node-gyp/11.15.0”
ERR! stack Error: EACCES: permission denied, mkdir ‘node_modules/sqlite3/.node-gyp’

[解决方法]:

npm install --unsafe-perm

Node.js 基础项目结构

一个 Node 项目通常是:

project
├─ node_modules
├─ package.json
├─ package-lock.json
├─ app.js
└─ routes

在 Node.js 生态中,通常有两个 核心基础配置文件

  • package.json : 这是每个 Node.js 项目的核心。它定义了项目的元数据、依赖项和运行脚本。
  • .env : 我们绝不应该把数据库密码、API 密钥等敏感信息直接写在代码里。通常配合 dotenv 库使用。

package.json 配置文件详解

{
"name": "admin",
"version": "4.4.0",
"description": "A magical vue admin. An out-of-box UI solution for enterprise applications. Newest development stack of vue. Lots of awesome features",
"author": "Auth <auth@gmail.com>",
"main": "app.js",
"scripts": {
"dev": "vue-cli-service serve",
"build": "prisma generate && nest build",
"lint": "eslint --ext .js,.vue src",
"build:prod": "vue-cli-service build",
"build:stage": "vue-cli-service build --mode staging",
"start": "nest start",
"preview": "node build/index.js --preview",
"new": "plop",
"svgo": "svgo -f src/icons/svg --config=src/icons/svgo.yml",
"test:unit": "jest --clearCache && vue-cli-service test:unit",
"test:ci": "npm run lint && npm run test:unit"
},
"dependencies": {
"axios": "0.18.1",
"clipboard": "2.0.4"

},
"devDependencies": {
"@vue/cli-plugin-babel": "4.4.4",
"@vue/cli-plugin-eslint": "4.4.4",
"vue-template-compiler": "2.6.10"
},
"browserslist": [
"> 1%",
"last 2 versions"
],
"bugs": {
"url": "https://github.com/PanJiaChen/vue-element-admin/issues"
},
"engines": {
"node": ">=8.9",
"npm": ">= 3.0.0"
},
"keywords": [
"vue",
"admin",
"dashboard",
"element-ui",
"management-system"
],
"license": "MIT",
"lint-staged": {
"src/**/*.{js,vue}": [
"eslint --fix",
"git add"
]
},
"husky": {
"hooks": {
"pre-commit": "lint-staged"
}
},
"repository": {
"type": "git",
"url": "git+https://github.com/PanJiaChen/vue-element-admin.git"
}
}

  • name & version : 项目名称和版本。发布 npm 包时这是必填的唯一标识。
  • main : 程序主入口,Node 默认的执行文件。
  • scripts : 这是整个配置中最重要的部分。它定义了 快捷命令(命令脚本) :
    • "start": "node app.js" -> 执行 npm start 命令,实际会运行 node app.js 启动程序。
    • "dev": "vue-cli-service serve" -> 执行 npm run dev 命令,会使用 vue-cli-service serve 启动服务
  • dependencies : 行环境必需的包(如 express, mongoose 等)。安装命令: npm install <pkg> 。
  • devDependencies : 仅开发环境需要的包(如 eslint, jest, nodemon )。安装命令: npm i <pkg> -D 。
  • engines : 指定 Node.js 或 npm 的版本范围,防止因环境版本不同导致代码崩溃。

初始化项目 ,会生成 package.json

npm init

安装依赖

npm install

启动

node app.js

PM2

如果直接使用 node app.js 这种方式启动,会存在以下问题:

  • 1️⃣ 程序崩溃自动退出,不会自动启动
  • 2️⃣ 服务器重启后,程序不会自动启动
  • 3️⃣ 无法负载均衡
  • 4️⃣ 日志不好管理

PM2 就是为解决这些问题而生,它是 Node.js 最流行的进程管理工具 。主要负责以下功能:

功能 说明
进程守护 程序崩溃自动重启
负载均衡 Node.js 是单线程的, pm2 可以让其充分利用多核 CPU 实现多进程
日志管理 自动手机程序日志
开机自启 服务器启动自动运行
性能监控 CPU/内存
后台运行 让程序以守护进程(Daemon)方式在后台运行

PM2 启动程序,假设程序是 app.js

pm2 start app.js --name "app-name"

查看进程状态

pm2 list

pm2 常用命令

  • 程序生命周期管理

    pm2 start app.js

    pm2 restart app-name|all|id

    pm2 stop app-name|all|id

    pm2 delete app

    pm2 reload <name> --update-env # PM2 会缓存环境变量。如果你修改了配置文件中的 env 变量,直接 pm2 restart 有时是不生效的。

    pm2 reload all # 平滑重启, 相比 restart,reload 会逐个重启进程,实现 0 秒停机

    pm2 env <name> # 查看程序加载的 env 配置,这在定位问题时很有用,通过此命令可以直观的看到程序加载的环境变量
  • 查看进程

    pm2 list
  • 日志管理

    pm2 logs     # 默认日志位置 ~/.pm2/logs
    pm2 logs app-name

    pm2 flush # 清空日志

    pm2 set pm2-logrotate:max_size 10M # PM2 日志会越来越大。建议配置 日志轮转
  • 监控程序,查看 CPU/Memory 实时监控界面

    pm2 monit
  • 配置 pm2 开机自启动

    pm2 save      # 保存当前进程列表
    pm2 startup # 生成启动脚本命令,复制终端弹出的那行代码并执行。
    pm2 resurrect # 查看开机启动进程

PM2 集群模式

Node.js 是单线程 。PM2 可以启动 多进程利用多核 CPU 。

  • ✔ 提高性能

  • ✔ 提高并发

  • ✔ 程序挂掉自动拉起

  • 集群模式启动命令

    pm2 start app.js -i max
    • -i max : 根据 CPU 核心数启动,如 4 vCPU 则启动 4 个 node 进程。

PM2 配置文件

生产环境一般使用 ecosystem.config.js 作为 pm2 管理配置文件来管理所有的项目,让你的部署过程 版本化、自动化、可复用 。

ecosystem.config.js
module.exports = {
apps : [{
// --- 基础配置 ---
name: "myapp", // 应用名称,用于 pm2 list 展示
cwd: "./", // 应用运行的根目录
script: "app.js", // 启动脚本路径
args: "-- port 3000", // 传递给运行脚本的参数

// --- 进阶控制 ---
instances: "max", // 开启集群模式,利用多 CPU。数字或 "max"(根据 CPU 核心数启动)
exec_mode: "cluster", // 模式:'cluster'(集群)或 'fork'(单实例),默认为 'fork'
watch: false, // 监控目录,文件变动则自动重启,'false' 或者监控目标 '["node_modules", "logs"]'
ignore_watch: [ // 忽略监听目录,防止频繁重启。
"node_modules",
"logs"
],

// --- 日志管理 ---
error_file: "./logs/err.log", // 错误日志路径
out_file: "./logs/out.log", // 普通输出日志路径
log_date_format: "YYYY-MM-DD HH:mm:ss", // 给日志加上时间戳

// --- 环境变量控制 ---
env: { // 默认环境变量 (pm2 start)
NODE_ENV: "development"
},
env_production : { // 生产环境变量 (pm2 start --env production)
NODE_ENV: "production"
},

// --- 重启策略 ---
autorestart: true, // 程序崩溃是否自动重启
min_uptime: 60, // 程序运行多久才算启动成功
max_restarts: 10, // 最大重启次数,防止程序有问题还一直不停重启
max_memory_restart: "1G", // 内存占用超过 1G 则自动重启,防止内存泄漏
restart_delay: 3000 // 异常重启之间的延迟(毫秒)

}]
}
  • 启动命令
pm2 start ecosystem.config.js

pm2 start ecosystem.config.js --env production # 启动生产环境 env

使用 PM2 配置文件时,需要注意以下事项:

  • 集群模式(Cluster)与单实例(Fork)

    如果你的应用是单机版的,没做多进程适配(例如:在内存里存 Session、使用本地变量计数),开启 instances: max 会导致数据不一致。

    生产环境尽量使用 cluster 模式以压榨多核性能,但确保你的应用是 无状态(Stateless) 的。

  • 内存溢出防御

    • Node.js 程序如果不小心写了内存泄漏,长期运行会导致服务器宕机。
    • 务必配置 max_memory_restart 。比如你的服务器有 2G 内存,给每个实例设个 800M 左右的阈值,能有效防止全机卡死。
  • 避免 无限重启循环

    • 如果你的程序在启动阶段就报错,PM2 会疯狂尝试重启。
    • 设置 min_uptime (程序运行多久才算启动成功)和 max_restarts (最大重试次数),避免刷爆 CPU 和日志文件。
  • Watch 模式的风险

    • 不要在生产环境开启 watch: true
    • 生产环境下任何小的配置改动或日志写入(如果路径不对)都可能触发进程重启,导致服务抖动。 watch 仅建议在开发或测试环境使用。
  • 环境变量的优先级

    • PM2 会缓存环境变量。如果你修改了配置文件中的 env 变量,直接 pm2 restart 有时是不生效的。
    • 建议使用 pm2 reload <name> --update-env 或直接 pm2 delete 后再重新 start 。

在 Docker 以及 Docker Compose 容器化场景下,监控不能只看容器活着没,而要覆盖以下 5 个层面:

  • 主机层 :CPU、内存、磁盘、网络、负载、文件系统、I/O
  • 容器层 :容器 CPU/内存/网络/重启次数/文件系统/生命周期
  • 应用层 :Nginx、MySQL、Redis、Java、Go、Python 等业务指标
  • 日志层 :容器 stdout/stderr 、应用日志、错误日志、访问日志
  • 可用性层 :HTTP/TCP/接口探测、业务 SLA、告警闭环

核心原则:

  • 指标、日志、告警分离
  • 先统一采集,再按业务细化
  • 容器监控 + 应用监控 + 主机监控三位一体
  • 所有组件都容器化,便于 Compose 管理
  • 尽量少侵入业务容器

基础监控栈

  • Prometheus :指标采集与存储
  • Grafana :可视化大盘
  • Alertmanager :告警路由与收敛
  • cAdvisor :容器指标采集
  • docker daemon metrics
  • Node Exporter :宿主机指标采集

日志栈

  • Loki :日志存储
  • Promtail :日志采集

或者你也可以换成 ELK/EFK,但在 Compose 中 Loki 更轻量、更容易落地

应用 Exporter(按需加)

  • MySQL Exporter
  • Redis Exporter
  • Nginx Exporter
  • Postgres Exporter
  • MongoDB Exporter
  • JMX Exporter(Java)
  • 自研应用 /metrics 接口

日志栈常用组件选择

promtail 和 fluentbit , filebeat 比较

工具 核心定位 特点
Promtail Loki 专用日志采集器(强绑定 Grafana 生态) 只服务 Loki
配置简单
强依赖 label(标签体系)
与 Grafana 联动极好
基本不通用
Fluent Bit 轻量级、高性能日志采集/转发器(云原生首选) 云原生事实标准、CNCF 项目(和 Kubernetes 生态融合好)
插件体系强、最通用、最灵活
支持输出到:
- Loki
- Elasitcsearch
- Kafaka
- S3
- Opensearch
- ClickHouse
- HTTP
Filebeat ELK 生态日志采集器(Elastic 官方) 深度集成 Elasticsearch + Logstash + Kibana
内置大量 module(nginx、mysql、system 等)
优势:开箱即用、解析能力强
劣势:资源占用较高、生态绑定严重

promtail 和 fluentbit , filebeat 性能比较

项目 Promtail Fluent Bit Filebeat
内存占用 ⭐⭐ ⭐⭐⭐⭐(最低) ⭐
CPU 占用 ⭐⭐ ⭐⭐⭐⭐ ⭐⭐
吞吐能力 中等 ⭐⭐⭐⭐(非常高) 较高
启动速度 快 ⭐⭐⭐⭐ 较慢
高并发日志 一般 ⭐⭐⭐⭐ 较好

promtail 和 fluentbit , filebeat 日志处理能力(解析/清洗)

能力 Promtail Fluent Bit Filebeat
正则解析 ✔️ ✔️ ✔️
JSON 解析 ✔️ ✔️ ✔️
Pipeline 处理 ⭐⭐ ⭐⭐⭐⭐ ⭐⭐⭐⭐
Lua/扩展脚本 ❌ ✔️ ✔️(processor)
复杂 ETL 能力 弱 强 很强

AlertManager 选择

Grafana 集成的 Alertmanager 还是 Prometheus 集成的 Alertmanager ?

👉 优先选择:Prometheus 原生 Alertmanager(强烈推荐)

👉 Grafana Alerting 适合作为补充,而不是主告警系统

两种架构对比

维度 Prometheus + Alertmanager Grafana Alerting
架构职责 清晰(采集 / 存储 / 告警分离) 混合(Grafana 做太多)
解耦程度 ⭐⭐⭐⭐ ⭐⭐
稳定性 ⭐⭐⭐⭐(生产级) ⭐⭐⭐
可控性 ⭐⭐⭐⭐ ⭐⭐⭐
学习成本 ⭐⭐⭐ ⭐⭐
多数据源支持 ❌(只 Prometheus) ⭐⭐⭐⭐
UI 操作 ❌(写 YAML) ⭐⭐⭐⭐
运维规范性 ⭐⭐⭐⭐ ⭐⭐

Prometheus Alertmanager 的优势(重点)

  • ✅ 1)真正的 运维级告警系统

    • 告警逻辑在 Prometheus(靠近数据)
    • 告警分发在 Alertmanager(专业做路由)

    👉 职责清晰、可控性强

  • ✅ 2) 强大的告警路由能力

    Alertmanager 支持:

    • 分组(group_by)
    • 抑制(inhibit_rules)
    • 静默(silence)
    • 去重(dedup)
    • 升级策略(escalation)

    👉 Grafana 很难做到同级别复杂度

  • ✅ 3) 抗压能力强(生产关键)

    Prometheus + Alertmanager:

    • 告警计算在 Prometheus
    • Alertmanager 专职处理

    👉 不会因为 Grafana 挂掉导致告警失效

  • ✅ 4) 支持大规模告警治理

    例如:

    • 10 万+ time series
    • 多环境(dev/staging/prod)
    • 多团队告警路由

    👉 Prometheus 体系更成熟

  • ✅ 5)行业标准

    几乎所有生产环境:

    • Kubernetes
    • 云原生平台
    • 大厂监控体系

    👉 都是 Prometheus + Alertmanager

  • ✅ 5) 版本/状态管理

    • 容易 GitOps
      👉 Grafana 配置在 DB,不好 GitOps,不易审计

Grafana Alerting 的优势

  • ✅ 1) 支持多数据源告警(最大优势)

    Grafana 可以对:

    • Prometheus
    • Loki
    • Elasticsearch
    • MySQL
    • CloudWatch

    统一做告警

    👉 Prometheus 做不到

  • ✅ 2) UI 配置(非常友好)

    • 不用写 YAML
    • 点点点就能配
    • 对新手友好
  • ✅ 3) 适合日志告警

    比如:

    • Loki 日志错误数
    • Elasticsearch error log
    • SQL 查询结果

    👉 Prometheus 不擅长日志

  • ✅ 4) 适合小团队

    • 不需要复杂告警治理
    • 不需要多环境策略

docker daemon 进程监控

监控 Docker Engine,可以开启 Docker daemon metrics

/etc/docker/daemon.json
{
"metrics-addr": "0.0.0.0:9323",
"experimental": true
}

重启 Docker

systemctl restart docker

Prometheus 增加抓取 Docker Daemon Metrics:

- job_name: docker-daemon
static_configs:
- targets: ['host-ip:9323']

这样能看到:

  • Docker Engine 内部指标
  • 镜像拉取行为
  • 守护进程状态
  • API 请求等

cAdvisor 部署和采集

cAdvisor(Container Advisor)主要负责:

  • 容器 CPU / 内存 / 网络 / 磁盘
  • 容器生命周期
  • Docker runtime 统计
  • cgroup 级别资源

👉 不负责:

  • 应用指标(要 exporter)
  • 日志(要 Loki/ELK)
  • 告警(要 Prometheus + Alertmanager)

cAdvisor 推荐作为一个独立的监控容器运行,最小可用 docker-compose.yml 参考

docker-compose.yml

services:
cadvisor:
image: gcr.io/cadvisor/cadvisor:latest
container_name: cadvisor
restart: unless-stopped
privileged: true

ports:
- "8080:8080"

volumes:
- /:/rootfs:ro
- /var/run:/var/run:ro
- /sys:/sys:ro
- /var/lib/docker:/var/lib/docker:ro
- /dev/disk:/dev/disk:ro

devices:
- /dev/kmsg


  • /var/lib/docker 用来读取容器元数据(必须)
  • /sys ,/proc 获取 cgroup 和资源统计
  • /var/run 读取 Docker socket 信息
  • privileged: true 解决权限问题(生产建议保留)
  • /dev/kmsg 采集 kernel 相关指标(可选但推荐)

启动 cAdvisor 并通过 http://<host-ip>:8080 或 http://<host-ip>:8080/metrics 验证是否能看到:

  • 容器列表
  • CPU / Memory / Network 图表

在 Prometheus 中使用以下配置接入:

scrape_configs:
- job_name: cadvisor
static_configs:
- targets: ['cadvisor:8080']

class Question(models.Model):
question_text=models.CharField(max_length=200)
pub_date=models.DateTimeField('datepublished')

def__str__(self):
returnself.question_text

class Choice(models.Model):
question=models.ForeignKey(Question,on_delete=models.CASCADE)
choice_text=models.CharField(max_length=200)
votes=models.IntegerField(default=0)

def__str__(self):
returnself.choice_text


上例中,Choice 引用了 Question 作为外键,在模板中通过 Question 对象获取所有引用了 Question 对象的 Choice 对象,可以使用以下方法:

{% for choice in question.choice_set.all %}
<li>{{choice.choice_text}}</li>
{%endfor%}

使用 question.choice_set.all 的方式获取所有引用 question 对象的 Choice 对象实例

环境信息

  • Centos7

  • Python3

  • wcs-python3-sdk (5.0.35)

网宿云 python sdk 安装命令 pip3 install wcs-python3-sdk , 安装后包含 cli 工具 wcscmd

初始化配置

wcscmd --configure [--config=FILE] 

--config=FILE 配置文件存储路径,默认 ~/.wcscfg [1]

wcscmd 常用操作

wcscmd listbucket 
wcscmd stat wcs://BUCKET/OBJECT \# 查询文件信息
wcscmd deletePrefix wcs://BUCKET PREFIX \# 根据前缀(文件路径,必须从头开始匹配,不需要最前面的/)删除目录或文件
wcscmd put wcs://BUCKET/file file

列出所有的文件

以下命令列出所有文件列表,并写入文件中

wcscmd listall wcs://BUCKET ./temp/f

python3 sdk 操作

from wcs.commons.config import Config
from wcs.services.client import Client

config_file = "/root/.wcscfg"
cfg = Config(config_file)
cli = Client(cfg)
bucketName = "TestBucket"
buckList = cli.bucket_list(bucketName, marker='') # 列出bucket中的文件列表,每次最多获取1000个,第一页 `marker=''`, 请求第一页的响应中marker的值为新的页的marker,可通过新的marker继续发起请求

脚注

530 Login incorrect

报错信息 : 登录时报错 530 Login incorrect
错误原因 :

/etc/pam.d/vsftpd
auth  required pam_listfile.so item=user sense=deny file=/etc/vsftpd/ftpusers onerr=succeed 

默认情况下,/etc/vsftpd/ftpusers 里面的用户是被拒绝登录的,确保要登录的用户不在此文件中

/etc/pam.d/vsftpd
auth       required    pam_shells.so  

此配置指定,只允许登录 shell 为 /etc/shells 中的 shell 的用户登录
如果用户 shell 为 /sbin/nologin ,则不允许登录,可改为 pam_nologin.so

阅读全文 »

环境信息

  • Centos 7
  • predixy-1.0.5

安装

下载地址, clone 或下载最新的版本或指定版本下载后解压

yum install libstdc++-static -y
cd predixy-1.0.5
make
cp src/predixy /usr/local/bin/

需要依赖 libstdc++-static , 否则 make 会报错:

/bin/ld: cannot find -lstdc++
collect2: error: ld returned 1 exit status
make[1]: *** [predixy] Error 1
make[1]: Leaving directory `/root/predixy-1.0.5/src'
make: *** [default] Error 2

配置文件说明

  • predixy.conf,整体配置文件,会引用下面的配置文件

  • cluster.conf,用于 Redis Cluster 时,配置后端 redis 信息

  • sentinel.conf,用于 Redis Sentinel 时,配置后端 redis 信息

  • auth.conf,访问权限控制配置,可以定义多个验证密码,可每个密码指定读、写、管理权限,以及定义可访问的健空间

  • dc.conf,多数据中心支持,可以定义读写分离规则,读流量权重分配

  • latency.conf, 延迟监控规则定义,可以指定需要监控的命令以及延时时间间隔

启动

predixy /predixy/conf/predixy.conf

使用默认的配置文件 predixy.conf, predixy 将监听地址 0.0.0.0:7617,后端的 redis 是 Redis Cluster 127.0.0.1:6379

环境信息

  • Mysql 5.7 之后版本支持多主一从

配置步骤

分别在 Master_1 和 Master_2 上导出需要同步的数据库

分别在 Master_1 和 Master_2 上执行以下命令,导出需要同步的数据库备份

Master_1
mysqldump -uroot -p123456 --master-data=2 --single-transaction --databases  --add-drop-database  db1  > db1.sql
Master_2
mysqldump -uroot -p123456 --master-data=2 --single-transaction --databases  --add-drop-database  db2  > db2.sql

备份完成后,将备份数据拷贝到从库服务器上面

阅读全文 »

Mysql 主从同步基本原理

复制的基本过程如下:

  1. Slave 上面的 IO 进程连接上 Master,并请求从指定日志文件的指定位置(或者从最开始的日志)之后的日志内容;

  2. Master 接收到来自 Slave 的 IO 进程的请求后,通过负责复制的 IO 进程,根据请求信息,读取指定日志指定位置之后的日志信息,返回给 Slave 的 IO 进程。返回信息中除了日志所包含的信息之外,还包括本次返回的信息已经到 Master 端的 bin-log 文件的名称以及 bin-log 的位置;

  3. Slave 的 IO 进程接收到信息后,将接收到的日志内容依次添加到 Slave 端的 relay-log 文件的最末端,并将读取到的 Master 端的 bin-log 的文件名和位置记录到 master-info 文件中,以便在下一次读取的时候能够清楚的告诉 Master “我需要从某个 bin-log 的哪个位置开始往后的日志内容,请发给我”;

  4. Slave 的 Sql 进程检测到 relay-log 中新增加了内容后,会马上解析 relay-log 的内容,获得在 Master 端真实执行的那些可执行的内容,并在自身执行。

双主情况下,禁止同时写入,建议还是按照主从的方式工作,防止数据冲突。双主场景下,主要是切换主备方便。

阅读全文 »

模板中需要循环中循环, {% for i in alist %} ,假如 i 是个元组或列表,需要继续循环:

{% for i in alist %}
{% with temp=I %}
{% for k in temp %}
…
{% endfor %}
{% endwith %}
{%endfor%}

或使用如下方式,data = [[1,2],[3,4]]:

{% for l in data%}

{% for temp in l % }
{% if forloop.first % }
'{{temp}}',
{% else %}
{{temp}}
{% endif %}
{% endfor %}

{%endfor%}

HCL AppScan(原名 IBM Security AppScan)是原 IBM 的 Rational 软件部门的一组网络安全测试和监控工具,2019 年被 HCL 技术公司收购。AppScan 旨在在开发过程中对 Web 应用程序的安全漏洞进行测试。

阅读全文 »

妊娠纹的形成与遗传、孕前体重、孕期体重增长速度、胎儿大小等因素关系很大。即使使用妊娠油,也不能保证完全不长妊娠纹。相比产品本身,更重要的是:

  • 保持体重按医生建议平稳增长;
  • 每天坚持保湿;
  • 保持充足饮水和均衡营养。

这样更有利于维持皮肤状态,降低严重妊娠纹发生的风险。

妊娠油 建议优先考虑安全性、保湿能力和耐受性,而不是宣传的 “100%预防妊娠纹”,因为目前没有任何妊娠油或乳霜能够被高质量研究证实可以完全预防妊娠纹。它们的主要作用是保持皮肤滋润、缓解瘙痒、改善皮肤弹性。

推荐等级

第一梯队(推荐)

Bio-Oil Skincare Oil(百洛护肤油)

推荐指数:★★★★★

优点:

  • 全球使用广泛。
  • 质地较轻,容易吸收。
  • 对孕期皮肤干燥和瘙痒有帮助。

缺点:

  • 含有香精,如果你孕吐严重、对气味敏感,可能会觉得味道偏重。

适合:

  • 大多数孕妇。

Mustela Maternity Stretch Marks Oil(妙思乐孕纹油)

推荐指数:★★★★★

优点:

  • 专门针对孕妇开发。
  • 99% 天然来源成分。
  • 不含矿物油、酒精、对羟基苯甲酸酯(Parabens)。
  • 气味通常较温和。

适合:

  • 孕早期到产后持续使用。

选择 105ml 无香版本

Weleda Pregnancy Body Oil(维蕾德孕妇按摩油)

推荐指数:★★★★☆

优点:

  • 天然植物油配方。
  • 保湿效果很好。

缺点:

  • 含植物精油,部分孕妇可能不喜欢气味。

第二梯队

Palmer’s(帕玛氏)

推荐指数:★★★★☆

优点:

  • 性价比高。
  • 可可脂保湿能力不错。
  • 在菲律宾也比较容易买到。

缺点:

  • 香味较明显。

需要避免的成分

孕期不建议选择含有以下成分的产品:

❌ 维 A 酸(Retinoids / Retinol)
❌ 高浓度水杨酸(Salicylic Acid)
❌ 来源不明的精油配方(尤其是未标明孕妇可用)

小孩获取 HongKong 身份的途径

已查阅香港入境事务处(immd.gov.hk)官网关于香港特区护照、居留权、身份证及出生登记的相关页面,整理出小孩子获得香港特区护照的完整逻辑和各条可行途径如下。

先说清楚一个前提 :香港特区护照本身的申请资格并不复杂——官网明确列明,任何人只要同时符合三点即可申请:

  • 是中国公民
  • 是香港特区永久性居民
  • 持有有效的香港永久性居民身份证(十一岁以下未持身份证的儿童,可与首次护照申请一并递交身份证申请)。

所以问题的关键不在护照申请这一步,而在于小孩如何先取得 “香港特区永久性居民” 身份。入境条例列明六类合资格人士,对小孩而言实际可行的路径主要有以下几种。

途径一:在香港出生,父或母其中一方是中国籍香港永久性居民

这是最直接的路径。根据条例,凡在香港特区成立前后于香港出生的中国公民即属永久性居民(不论父母是否居民身份,这是 1999/2001 年终审法院确立的原则)。

操作上:婴儿出生后 42 天内到出生登记处免费办理出生登记(超过 42 天但一年内需缴法定费用,超过一年须经批准);出生证明书核证副本收费 140 港元。11 岁以下持已注明永久性居民身份的香港出生证明书,一般无需再申请核实资格,可在年满 11 岁时直接领身份证;若急需出境用的旅行证件,可让父母同时申请 “核实资格并加签”(收费 350 港元,仅适用于持外国旅行证件且不足 11 岁者)。之后即可申请特区护照(16 岁以下五年有效期,32 页 215 港元/48 页 260 港元),处理时间一般 5 个工作天(如儿童未满 11 岁且未持身份证需一并申请身份证的,为 10 个工作天)。

需要提醒的是,若父母双方都不是香港居民(俗称 “双非”),虽然法律上孩子出生即可取得居留权,但香港医院管理局自 2013 年起对非本地孕妇(无香港配偶)的产科预约实施 “零双非” 配额限制,实际操作上很难安排在港分娩,这是行政层面的限制,而非入境条例本身的限制。

途径二:孩子在香港以外出生,父或母一方是中国籍香港永久性居民

这类 “在境外出生的中国籍子女” 依条例也享有居留权,但需要额外申请 “居留权证明书”(Certificate of Entitlement),并须贴附在孩子有效的旅行证件(或如果孩子经内地 “单程证” 来港定居,则贴附在单程证上)上才能确立身份。官网列明处理时间:95%的申请可在接获所需文件后三个月内完成(如亲子关系或资料有疑点则不适用此标准)。费用方面,官网收费表未单列居留权证明书本身的费用(核实资格与首次签发身份证均为免费,仅在需要在外国旅行证件上加签时才收 350 港元)。取得证明书、确立居留权后,再按上述流程申领身份证、护照。如果孩子和申请的父母目前常住内地,还涉及向内地公安机关申请 “单程证” 来港定居,这部分不属于入境处业务范畴,需另行了解内地对口政策。

途径三:父母先通过人才引进计划取得香港身份,子女以受养人身份来港,再累积居留满 7 年

以刚才您浏览的 “优秀人才入境计划” 为例,官网 “受养人的入境安排” 页面确认:获批来港的人才可携 18 岁以下未婚受养子女同行,但受养人的逗留期限与担保人(父/母)挂钩,属于有条件逗留,并非永久性居民身份。这条路径下小孩要真正拿到永久居民身份(进而申请护照),有两种可能:其一,若小孩在受养人签证有效期间在香港出生,则直接依 “途径一” 取得居留权;其二,若小孩非在香港出生,则需要以受养人身份在香港通常连续居住满 7 年(且父母/本人需以香港为永久居住地),才能申请核实永久性居民身份资格。这是耗时最长的路径,前后至少 7 年,且中途受养人签证需按担保人签证情况逐年/逐期续签(签证本身有相关申请费,如需要延期逗留等,具体费用见收费表中 “改变逗留条件” 类别,一般港币 330 元,指明计划下可能是 600–1300 港元)。7 年期满、核实资格通过后,身份证免费签发,之后再按护照标准流程申请(215/260 港元,5-10 个工作天)。

汇总对比

途径 核心条件 大致耗时 主要官方费用
一:香港出生 + 父母一方为永久居民 出生即符合资格 出生登记(免费/42 天内)+ 护照申请 5-10 工作天,整体最快可在数周内完成 出生证明副本 140 港元;护照 215/260 港元;如需加签 350 港元
二:境外出生 + 父母一方为永久居民 需申请居留权证明书确立身份 证明书 95%在 3 个月内办妥,之后再办身份证、护照 证明书本身官网未列费用(核实资格免费);护照 215/260 港元;如需加签 350 港元;如涉及内地单程证另计内地费用/时间
三:父母以人才计划来港,子女受养人身份,居满 7 年转永久居民 通常居住连续 7 年以香港为永久居住地 至少 7 年 受养人签证/续签费用(每次约 330-1300 港元不等,视计划而定);7 年后核实资格免费,护照 215/260 港元

简单说:如果孩子能在香港出生且父母中至少一人已是香港永久性居民,这是成本最低、耗时最短的方式,出生后几周到几个月内即可拿到护照;如果孩子在境外出生但父母一方已是永久居民,需要多走 “居留权证明书” 这一步,官方承诺的处理时间是 3 个月(95%案件),加上后续护照申请的几个工作天;如果父母是通过优秀人才计划等先来港,子女只是受养人身份,则子女本人要拿到护照通常需要等到全家在港连续居住满 7 年、父母或子女本人转为永久居民之后,这是最慢的一条路,耗时以年计。
以上信息均来自入境事务处官网(immd.gov.hk)”申请香港特别行政区护照”,”居留权”,”出生及死亡登记”,”收费表” 及 “优秀人才入境计划” 等页面。需要注意的是,具体到个案(比如父母国籍组合、孩子出生地、是否涉及内地户籍等)时,实际操作细节可能有差异,建议在决定具体路径前直接致电或前往入境事务处查询,或参考页面上的常见问题(FAQ)栏目做进一步确认。

香港永久性居民

在香港, 永久性居民 与 居留权 是绑定的: 拥有香港特区居留权的人即为永久性居民 。

要真正行使居留权,必须持有以下其中一种有效证明文件:

  • 有效的永久性居民身份证
  • 有效并已附贴于旅行证件上的居留权证明书,或有效的香港特区护照。

大陆籍人士属于 “中国公民”。根据《入境条例》附表 1,中国公民只要符合以下任一条件即为香港永久性居民、享有居留权:

  • 在香港出生的中国公民;
  • 在香港通常居住连续 7 年或以上的中国公民;
  • 前两类中国公民在香港以外所生的中国籍子女(须在其出生时父/母已属前两类)。

对绝大多数在内地出生、成长的大陆籍人士而言,适用的是第二条——先合法来港定居,通常居住满连续 7 年,即可取得永久性居民身份。

整体流程(三大步骤)

第一步:取得来港定居的资格(这一步在内地办理,不由香港入境处审批)

大陆居民赴港定居主要凭 《前往港澳通行证》(俗称 “单程证”) ,由内地公安机关出入境管理部门按国家审批制度签发(如夫妻团聚、子女投靠父母、老人投靠子女等类别)。此外,也可通过香港的各类入境计划合法来港居住,例如:输入人才/专才、优秀人才入境计划、非本地毕业生留港安排、以受养人身份随行等。这些途径来港后同样开始累计在港居住年期。
香港政府一站通 “为非永久性居民提供的服务” 中还列有一项 输入中国籍香港永久性居民第二代计划 ,专门面向在内地出生、父母为中国籍香港永久性居民的第二代人士,可在网上向入境处提交入境申请。

第二步:在香港通常居住连续 7 年

持有效证件进入香港后,需在香港 “通常居住” 连续满 7 年。期间应保留能证明连续居住的文件,例如学校文件、就业证明、正式收据、银行结单、入息税税单、以及显示抵港日期和逗留条件的旅行证件(如单程通行证、签证身份书)等。

第三步:向入境处申请 “核实永久性居民身份证资格” 并换领永久性居民身份证

满足条件后,向入境事务处提出 “核实永久性居民身份证资格” 申请(申请时须身处香港),获核实后即可登记领取永久性居民身份证,这张证件即证明持证人拥有香港特区居留权、成为永久性居民。

可选路径

大陆籍人士(中国公民)取得香港永久性居民身份的所有可选路径系统整理如下。

需要先说明一个共同原则:除极少数情形外,几乎所有路径的最终逻辑都是—— 先通过某种合法途径来港居住 → 在香港 “通常居住” 连续满 7 年 → 向入境处申请核实资格、换领永久性居民身份证 。区别只在于 如何合法来港并累计 7 年居住 。以下按类别列出。

亲属团聚类(凭内地签发的证件来港定居)

这类路径由内地公安机关出入境管理部门审批,香港入境处不参与审批:

单程证(《前往港澳通行证》) —— 最主要的家庭团聚途径,用于夫妻团聚、内地子女投靠香港的父母、老人投靠子女等。持单程证来港即属定居,之后累计满 7 年可申请永久性居民身份(换领身份证时用表格 ROP169,18 岁以下用 ROP170)。名额和审批标准由内地方面掌握。

吸引人才类(由香港入境处审批)

官网 “吸引人才” 分类下列出以下计划,来港工作居住满 7 年后可转永久性居民:

  • 高端人才通行证计划(高才通) — 面向高薪人士及顶尖大学毕业生。
  • 输入内地人才计划(专才) - 受聘于香港公司、具备本地缺乏的专业知识技能者。
  • 一般就业政策 - 受聘来港就业(含技术专才类别)。
  • 优秀人才入境计划(优才) — 计分制,不需先获聘。
  • 科技人才入境计划 - 为指定科技公司引入人才。
  • 非本地毕业生留港/回港就业安排(IANG) - 在港修读全日制本地课程毕业的非本地生。
  • 职专毕业生留港计划 - 职业专才教育毕业生。

输入中国籍香港永久性居民第二代计划(专门针对 “第二代”)

这是官网明确设立的专项计划,供已移居海外的中国籍香港永久性居民的第二代回港工作。申请资格包括:

  • 申请时年龄 18 至 40 岁;
  • 在中国内地、香港、澳门、台湾以外的海外出生;
  • 父或母至少一方在申请时持有效香港永久性居民身份证、且在申请人出生时是已定居海外的中国籍人士;
  • 具良好教育背景(通常指学士学位);
  • 具备良好中文或英文书写及口语能力;以及有足够经济能力。

重要提醒 : 该计划要求申请人 “在海外出生”。因此在中国内地出生的大陆籍人士不符合此计划资格——它面向的是香港永久性居民移居海外后在国外所生的子女,不是内地出生的第二代。

投资/创业类

  • 新资本投资者入境计划(现行)及资本投资者入境计划(旧计划,现只办延期) — 透过在港投资获准来港居留。
  • 企业家来港投资 — 在港开办或参与业务。

就读/受养人类

  • 学生 — 来港修读全日制课程,毕业后可衔接前述 IANG 等就业安排继续累计居住年期。
  • 受养人 — 以配偶或未成年子女等身份随获准来港的保证人(如各类人才、投资者)居港,同样计入 7 年居住年期。

EKS 集群特性总结

  • 节点的 IP 地址(EXTERNAL-IP 和 INTERNAL-IP)不固定,会变化。特别是在自治模式中,节点被视为 临时资源(Ephemeral) ,可能会频繁地进行节点池优化。

    如果集群需要固定的出口 IP,最推荐,最标准的做法是 使用 NAT 网关 ,将 EKS 节点部署在私有子网中,所有访问外部网络的流量都会经过 NAT 网关

通过 AWS 管理控制台部署 EKS 集群

  • Kubernetes 版本: v1.35

本示例中使用 EKS 自治模式(EKS Auto Mode)

EKS 自治模式 接管了原本需要手动管理的节点、存储和网络配置,因此它需要一组非常具体且强大的权限

EKS 自治模式 有额外的费用

EKS 自治模式 在集群创建完成后可修改(编辑)为非自治模式,但是不能通过 API 方式(如 Terraform)从普通模式切换到自治模式

EKS 自治模式 中的 Worker Nodes 配置 不能在控制台修改参数、不能自定义 ,具体的配置可以通过 API 接口查看 nodepool 资源

# kubectl describe nodepool general-purpose
Name: general-purpose
Namespace:
Labels: app.kubernetes.io/managed-by=eks
Annotations: karpenter.sh/nodepool-hash: 4012513481623584108
karpenter.sh/nodepool-hash-version: v3
API Version: karpenter.sh/v1
Kind: NodePool
Metadata:
Creation Timestamp: 2026-02-06T09:38:18Z
Generation: 1
Resource Version: 784637
UID: e85261b9-3a4b-41b0-ac5...
Spec:
Disruption:
Budgets:
Nodes: 10% # 这是一个安全阀。在同一时间内,由于缩容或更新导致的节点离线比例不能超过 10%。这保证了你的集群不会因为自动优化而导致业务大面积中断。
Consolidate After: 30s # 节点达到 Consolidation Policy 状态 30 秒后,EKS 就会考虑将其关闭,并把上面的 Pod 迁移到更划算的节点上。
Consolidation Policy: WhenEmptyOrUnderutilized # 当节点变为空闲(没有除 DaemonSet 外的其他 Pod)或者利用率较低(比如一个大节点只跑了一个小 Pod)时,EKS 会自动触发节点合并。
# 风险点:如果你的系统组件(如 CSI、ALB Controller)没有设置合理的 requests,EKS 会认为这些 Pod “不占地方”,从而选择一个极小的节点(如 4Gi 内存机型)来承载它们和一些大负载的 Workload,如 Confluence。
limits: # 资源限制
cpu: "1000"
memory: 1000Gi
Template:
Metadata:
Spec:
Expire After: 336h # 节点的最大“寿命”是 14 天(336 小时),强制节点定期更换,以确保所有节点都运行在最新的安全补丁和 Bottlerocket 镜像上,防止出现长期未重启的“僵尸节点”。
Node Class Ref: # nodeclass 信息,可通过 kubectl get nodeclass 查看
Group: eks.amazonaws.com
Kind: NodeClass
Name: default
Requirements: # 节点选择标准 (Requirements)
Key: karpenter.sh/capacity-type # 实例类型,on-demand 为 按需实例
Operator: In
Values:
on-demand
Key: eks.amazonaws.com/instance-category # 限定了实例系列 c: 计算优化型(适合高并发); m: 通用型(平衡 CPU 和内存); r: 内存优化型(适合数据库或缓存)。
Operator: In
Values:
c
m
r
Key: eks.amazonaws.com/instance-generation # 只使用 4 代以后的机型(如 c5, m6i 等)。这确保了节点拥有较新的硬件特性和性能。
Operator: Gt
Values:
4
Key: kubernetes.io/arch # CPU 架构。如果你想尝试性价比更高的 ARM 架构(Graviton),需要在这里添加 arm64
Operator: In
Values:
amd64
Key: kubernetes.io/os # 节点操作系统(OS)类型
Operator: In
Values:
linux
Termination Grace Period: 24h0m0s

EKS 自治模式限制资源上限 编辑 NodePool,修改 spec.limits.cpu 和 spec.limits.memory 。这决定了该池子最多能 “烧” 掉多少 EC2 资源。

强制回收节点 : 如果你想让 EKS 重新平衡节点(例如你更改了实例限制),可以手动删除节点,Auto Mode 会自动根据 Pod 需求拉起符合新规的新节点

kubectl delete node <node-name>

同时要关注 nodeclass 资源,其中定义了 子网(Subnet)和安全组(Security Group)等信息

# kubectl get nodeclass
NAME ROLE READY AGE
default eksNodeRole True 44h


# kubectl describe nodeclass default
Name: default
Namespace:
Labels: app.kubernetes.io/managed-by=eks
Annotations: eks.amazonaws.com/nodeclass-hash: 13740036326424352917
eks.amazonaws.com/nodeclass-hash-version: v2
API Version: eks.amazonaws.com/v1
Kind: NodeClass
Metadata:
Creation Timestamp: 2026-02-06T09:38:18Z
Finalizers:
eks.amazonaws.com/termination
Generation: 2
Resource Version: 827607
UID: 5065b0f3-3795-4347-893a-338ae6fa882d
Spec:
Ephemeral Storage:
Iops: 3000
Size: 80Gi
Throughput: 125
Network Policy: DefaultAllow
Network Policy Event Logs: Disabled
Role: eksNodeRole
Security Group Selector Terms:
Id: sg-058bd1ef...
Snat Policy: Random
Subnet Selector Terms:
Id: subnet-07963d9b...
Id: subnet-0e359aac...
Id: subnet-0e76c601...

AWS EKS Auto Mode 使用建议:

  • 使用 PriorityClass 来管理 Pod 的优先级,确保高优先级 Pod 先被调度 。确保即便在资源极度紧张时,核心控制器(如 ALB Controller, CSI)也能优先获得资源,甚至通过驱逐业务 Pod 来 “腾位子”。先创建不同的优先级对象。 优先级数值(Value)越高,重要程度越高 。

    # 1. 系统级核心组件优先级 (非常高)
    apiVersion: scheduling.k8s.io/v1
    kind: PriorityClass
    metadata:
    name: infrastructure-critical
    value: 1000000
    globalDefault: false
    description: "用于核心控制器,如 ALB, CSI, Metrics-server"
    ---
    # 2. 核心业务应用优先级 (中等)
    apiVersion: scheduling.k8s.io/v1
    kind: PriorityClass
    metadata:
    name: business-critical
    value: 10000
    globalDefault: false
    preemptionPolicy: Never # 抢占策略. 可选值:PreemptLowerPriority(默认值,驱逐低优先级 Pod), Never(从不驱逐低优先级 Pod,只想让高优先级 Pod 在排队时优先进入节点)
    description: "用于 Confluence 等核心生产应用"
    ---
    # 3. 普通/低优先级任务 (默认)
    apiVersion: scheduling.k8s.io/v1
    kind: PriorityClass
    metadata:
    name: low-priority
    value: 100
    globalDefault: true # 如果不指定优先级,默认走这个
    description: "用于开发测试、非核心后台任务"

    系统通常已经存在 PriorityClass 对象

    $ kubectl get priorityclass
    NAME VALUE GLOBAL-DEFAULT AGE PREEMPTIONPOLICY
    rancher-critical 1000000000 false 2d18h PreemptLowerPriority
    system-cluster-critical 2000000000 false 3d3h PreemptLowerPriority
    system-node-critical 2000001000 false 3d3h PreemptLowerPriority

    不要将 globalDefault 设为高优先级。
    给核心组件添加上 PriorityClass 对象,如 Deployment、DaemonSet 等

    spec:
    template:
    spec:
    priorityClassName: infrastructure-critical # 关联高优先级
    containers:
    - name: aws-load-balancer-controller
    resources:
    requests:
    cpu: 200m
    memory: 256Mi

    PriorityClass 的工作原理 :

    1. 当一个 高优先级 的 Pod 处于 Pending 状态(因为节点资源满了)时
    2. 寻找牺牲者(Victims) : 调度器会在现有节点中寻找优先级比它低的 Pod。
    3. 触发抢占(Preemption) : 调度器会从节点中驱逐(Evict)优先级低的 Pod。
    4. 腾出空间 : 一旦低优先级 Pod 被停掉释放了 CPU/内存,高优先级的 Pod 立即调度上去。
阅读全文 »